

みなさまこんにちは。配信プラットフォーム技術部 開発第1グループの岡田です。
以前ブログを投稿してから約2年が経ち、部署が変わりまして新しく覚えることやわからないことが多く、日々新卒の頃のような初心に戻って仕事に励んでおります。
さて、今回はある大規模動画配信サービスのバックエンドにて、Amazon ElastiCache for Redisのv5からAmazon ElastiCache for Valkeyのv8に移行した話をさせていただきます。
移行方法や移行までの流れ、確認した観点や直面した問題について共有できればと思いますので、ぜひ読んでいただけますと幸いです。
- この記事の対象読者とスコープ
- 用語の整理
- 要点まとめ(tl;dr)
- 移行の背景・目的
- 移行までの流れ
- 移行方式について
- データ移行について(RIOT実践編)
- 当日の切り替えの流れ
- 切り戻し(ロールバック)方針とその弱点
- 移行時に直面したトラブルと回避策
- まとめ
- 参考リンク
この記事の対象読者とスコープ
- 対象読者: ElastiCache for Redisを利用中で、Valkeyへの移行、あるいはRedisのバージョンアップを検討している方
- この記事で扱うこと: 移行方式の選定、影響度によるグループ分け、RIOTを使ったリアルタイムデータ同期の実務、当日の手順とハマりどころ
- この記事で扱わないこと: Terraformなどインフラコードの具体的な実装、アプリケーション側の細かな改修内容
用語の整理
はじめに、本記事でよく出てくる言葉を軽く整理しておきます。
- Valkey: Redisからフォークして作られた、Linux Foundation傘下のインメモリデータストア。Redisと高い互換性を持ちます。
- RIOT(Redis Input/Output Tools): RedisのGitHub organizationで公開されているデータ移行・比較ツール。既存データの一括コピー(Scan)と、更新差分をリアルタイムに追従する同期(Live)、および同期元/先の差分検証(compare)ができます。
- Keyspace Notifications: Redisがキーへの操作(SET/DELなど)をイベントとして通知する仕組み。RIOTのLive同期はこの通知を購読して差分を追従します。
要点まとめ(tl;dr)
先に結論と要点だけまとめます。詳細は各セクションをご覧ください。
- やったこと: Amazon ElastiCache for Redis v5 → Valkey v8への移行。既存Redisを残したまま新規にValkeyを構築し、Amazon Route 53のDNS切替で移行するブルー/グリーン方式を採用。DB切り替え自体のダウンタイムはゼロ。
- なぜこの方式か: インプレースアップグレードは切り戻しが困難なため不採用。AWSサポートにも相談し、「同期ワーカー方式」と「Dual Write方式」の2案からアプリ改修が少なく済む同期ワーカー方式を選定。
- データ欠損が許されないリソースへの対応: RedisのGitHub organizationで公開されているツールRIOTのLiveモードでリアルタイム差分同期を実施。AWSサポートから「Live同期は配信保証がない」という注意喚起を受け、チューニングと2段階検証(riot compare + 自作スクリプト)で確実性を担保。
- ハマったところ: RIOT(JVM)のメモリ上限、スレッド数を上げすぎたことによるフリーズ、DNS切り替え後のIPキャッシュ問題(Force Deployで解消)。
- 実測してわかったこと: 同期中の負荷はCPU・メモリよりもネットワーク送信帯域が先に頭打ちになる。事前検証のチューニングで適正な設定値を見つけ、本番実施時は問題なし。
- 成果: 最もクリティカルなセッションデータ等を含め、切り替え自体のダウンタイムはゼロ、新規ログイン・会員登録のみ短時間停止で実質的な欠損率0%で移行を完了。
- 切り戻し: 逆同期は用意しておらず、切り戻すとデータは先祖返りする。そのため切り戻し判断はメンテナンス明け前に行う設計とし、先祖返りによる不整合を防止。
移行の背景・目的
まず移行の背景ですが、Amazon ElastiCache for Redisのv5は2026年1月31日で標準サポートが終了となりました。対応としてはRedisのバージョンアップでも良かったのですが、今回はValkeyへの移行を決めました。
理由としては、以下の3点があります。
- ライセンスの不透明さ: Redisは2024年3月にv7.4以降でライセンスがそれまでのBSDからSSPLv1 / RSALv2のデュアルライセンスへ変更され、マネージドサービスとしての提供などに制約が生じた。この変更をきっかけにValkeyがフォークされた経緯もあり、当時は将来のライセンス方針的にRedisを使い続けるのはリスクがあると判断した。
- 互換性: ValkeyはRedisからフォークして作られているため、高い互換性がある。
- コスト: AWSではノードベース全般でValkeyがRedisよりも20%安く利用できる。(Amazon ElastiCache の料金)
※(補足1)ライセンスの現状について
その後2025年5月のRedis 8.0 GAで、OSI承認のAGPLv3が3つ目のライセンス選択肢として追加され、8.0から再びオープンソースライセンスに復帰しています。
本記事の移行判断は上記の経緯を踏まえた当時のものである点をご承知おきください。自社の利用形態でどのライセンスが問題になるかは、必ず最新の公式ライセンスページでご確認ください。※(補足2)Redis OSS v4/v5について
Redis OSS v4/v5は2026年1月31日で標準サポートが終了しますが、2026年2月1日以降も引き続き利用することは可能です。
ただし、延長サポート料金がかかりランニングコストが上がってしまうため、早めの対応が必要となります。
また、本システムではキャッシュやセッション管理、バックグラウンド処理のキュー管理など、様々な用途でElastiCache for Redisを多数利用していました。
動画配信サービスという特性上、視聴セッションやログインセッションが欠損すると、ユーザー体験に致命的な影響を与えることになります。
そのため、移行に伴う作業でのダウンタイムは最小限にすることと、万が一の場合の切り戻しもすぐにできる安全性を担保することが求められました。
移行までの流れ
対象の洗い出し
まず一番初めに行ったこととして、移行対象である全Redisリソースについて、以下の項目を調査・整理しました。
- 利用システム・用途(キャッシュ、セッション、キュー管理など)
- ノード数、ノードタイプ、データ容量
- TTL(Time To Live)の有無
- データ欠損時のサービスへの影響度
- Redis接続不可時のシステム挙動
特に、データ欠損時のサービスへの影響度やRedis接続不可時のシステム挙動を確認した理由としては、万が一の場合どのような状態になるのかを事前に把握しておくことで、最悪の事態を想定した上で事前準備や対応ができる状態を作りたかったからです。
また、今回の移行対象はクラスター単位で全部で15個あり、その中でも全Key数が数千万規模(検証では最大約6,400万件のスナップショット同期まで確認)でメモリ容量が約165GBのものがありました。
サービス影響度によるグループ分け
整理できた情報から、サービス影響度別にA〜Dのグループに分けました。
判定軸は「TTLの長さ」「データが消えても再生成できるか」「欠損時のユーザー影響」の3点です。
| グループ | 判定の考え方 | 主な用途 | 移行タイミング |
|---|---|---|---|
| A | TTLが極めて短く、消えても即再生成。影響なし | 一時的なAPIキャッシュ等 | いつでも無停止でOK |
| B | 再生成は可能だが、消えるとオリジンへ負荷集中の恐れ | マスタ/重いクエリ結果のキャッシュ | アクセスが少ない時間帯に無停止で実施 |
| C | フロント即時影響はないが、処理中ジョブの消失・不整合を防ぐ必要 | 非同期ジョブキュー、バッチのステータス管理 | ワーカー/バッチを一時停止して実施 |
| D | 欠損・不整合が致命的(突然ログアウト等) | ログインセッション、認証トークン、視聴セッション | メンテ or 同期ワーカーで確実にデータ移行 |
※ 今回の15個の内訳: A=4個 / B=5個 / C=1個 / D=5個
それぞれのグループの実施については、
- グループA,Bについて、日中帯のアクセスが少ない時間帯で実施。
- グループCについて、今回移行を実施したのが深夜だったため、運用調整をすることでデータが入らない状態を作り、実施。
- グループDについて、クリティカルなセッション等を含むため、データ移行はメンテナンスなしで行い、切り替え時のみ切り戻し安全性確保のため短時間のメンテナンスを実施。 詳細については後述。
補足: グループDについては、上記の通り実際には新規ログイン・会員登録のみを止める短時間のメンテナンスを実施しています
Redis → Valkeyの移行自体はメンテナンスなしで完結する設計でしたが、万が一切り戻しが発生した場合に逆同期ができず先祖返りが起きるため、Valkey切り替えから切り戻し判断が完了するまではログインセッションを扱うRedisに対する新規セッションが発生しないようにする必要がありました。
それ以外のグループDのRedisについては、先祖返りしても問題ないことを事前に確認しました。
移行方式について
AWSにおいて、RedisからValkeyへの移行方法としては、大きく分けて以下2つの方法があります。
- AWSのインプレースアップグレード
- 新規でValkeyを作成し切り替える
今回選んだ方法は2になります。
インプレースアップグレードを選ばなかった理由
① 検証環境でのダウンタイム発生
AWSの公式ドキュメントでは、既存のRedisからValkeyへのインプレースアップグレードは「ダウンタイムなし」という内容で案内されていました。
AWS公式より引用
ダウンタイムゼロの移行: ElastiCache for Redis OSSの既存ユーザーは、ダウンタイムゼロでElastiCache for Valkeyにすばやく移行できます。
しかし、事前にステージング環境などで試したところ、数秒間ですが接続不可状態になるダウンタイムが発生しました。
これ自体はそこまでサービス影響が大きくなる事象ではないため、これ単体が決め手にはなりませんでした。
② 安全なロールバックの確保(こちらが決め手)
万が一、アップデート後にアプリケーション側で予期せぬ不具合が発生した場合、インプレースアップグレードでは元の状態にすぐに切り戻すことが困難です。
本移行ではロールバックできないことは許容できなかったため、インプレースアップグレードは採用しない方針としました。
なお、裏を返せば「切り戻しを許容でき、データ移行の手間をかけたくない」ケースではインプレースは有力な選択肢です。
今回の私たちのように別リソースを立てる方式は、後述のとおり工数が確実に増えます。
移行方式の相談(AWSサポートへの事前相談)
新規にValkeyを作成する方式の弱点は、「スナップショット取得から切り替えまでの間に発生したデータ更新が漏れてしまう」ことです。
グループA・Bのようなキャッシュ用途や、運用調整でデータが入らなくなるグループCは問題ありませんが、グループDでは許容できません。
そこで、差分をどう同期するかを決めるにあたり、まずAWSサポートに移行方式を相談しました。
こちらの構成(Redis 5.0.6 → Valkey 8、保存データはすべてDurable、読み取り/書き込みの比率(9:1)、ピーク時でおおむね1万コマンド/秒規模)を共有したうえで、取り得る移行パターンを整理していただきました。
上記を踏まえて提示されたのは、大きく次の2つのパターンでした。
- ① 同期ワーカー方式(RIOT / RedisShake):
既存Redisを残したまま、同期ワーカーで旧→新へデータを同期し、アプリケーションの向き先をValkeyに切り替える方式。 今回検討していた構成に最も近いもの。 - ② Dual Write方式:
アプリケーションからRedisとValkeyの両方へ書き込み、読み取りは段階的にValkeyへ寄せていく方式。
AWSの事例記事でも採られている。
ただしアプリケーション側の改修が前提になる。
今回は、アプリケーション改修を最小限にしたかったこと、そして全データがDurableでメンテナンス枠も限られていたことから、① 同期ワーカー方式が最も要件に合うと判断しました。
同期ワーカーの候補としてはRIOTとRedisShakeが挙がり、最終的にRIOTを採用しました。
RIOTの決め手は以下の3点です。
- 既存データの一括コピー(Scan)に加えて更新差分を追従するLive同期がある
- 同期元/先の差分を検証するcompare機能が組み込まれている
- クラスターモードに対応している
AWSからの重要な注意喚起:Live同期は「配信保証」がない
この相談で特に有益だったのが、RIOTのLive同期に関する注意点の共有でした。
Live同期はKeyspace Notifications(Redisのpub/sub)を購読して差分を追従しますが、pub/subの性質上、通知の配信は保証されません。
ネットワーク障害時などに通知を取りこぼす可能性があります。
また、頻繁に更新される巨大なコレクション(大きなSetなど)があると、更新のたびに全体を読み直して転送するため、変更ストリームにRIOTが追いつけなくなります。
この結果、内部キューが溢れて更新が欠落し得る、という趣旨の注意です(RIOT公式ドキュメントの記載に基づく)。
AWSサポートからの標準的な提案は「メンテナンス枠で書き込みを止め、最終差分はScanモードで確実に同期する」というものでした。
しかし、今回は最もクリティカルなグループで全書き込みを止めるメンテナンス枠を確保できなかったため、Liveモードでの継続同期を採用しつつ、その信頼性を後述のチューニングと2段階検証で担保する方針としました。
ステージング検証でスレッド数を上げすぎた際にRIOTが停止した事象(後述)も、この「追いつけない」挙動と関連した話であり、AWSの注意喚起は実際の検証結果と合っていました。
全体構成
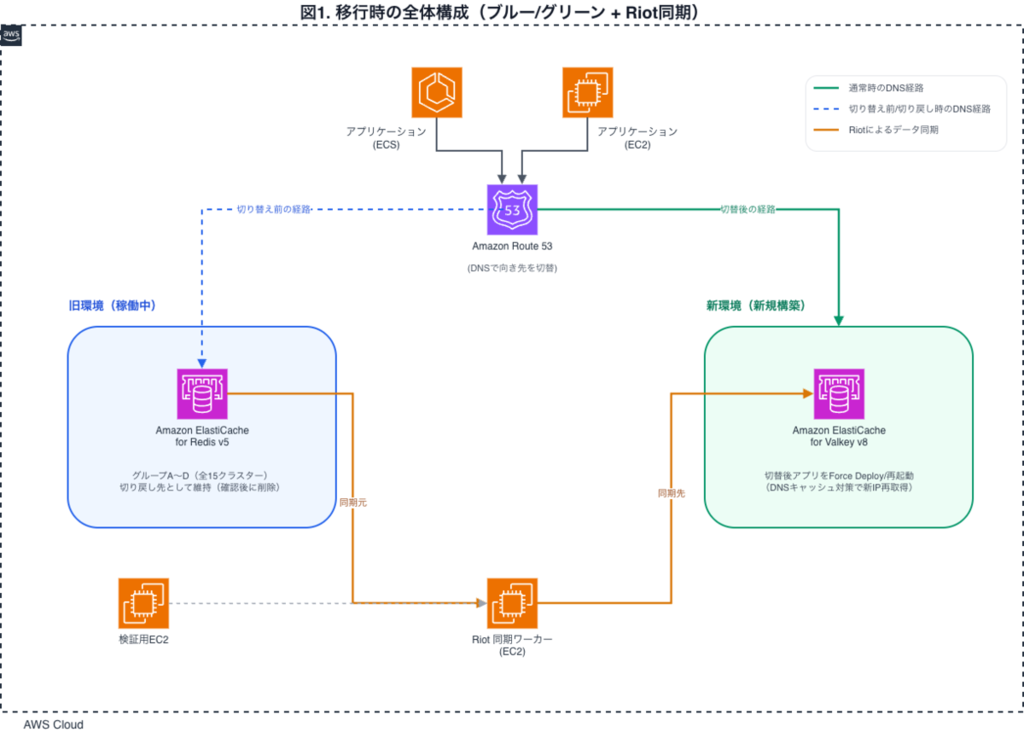
採用したのは、「既存のRedisを残したまま、スナップショットから新規にValkeyクラスターを作成し、DNS(Route 53)の向き先を切り替える」という、ブルー/グリーンデプロイメントに近い方式です。
これにより、切り替え中も常にどちらかのDBを参照できる状態となり、DB切り替えに伴うダウンタイムは発生しません。
また、不具合があればDNSの向き先を戻すだけで、数分で旧環境へロールバックできる状態を担保しました。
同期ワーカーを採用したグループDについては、スナップショットはバックアップ用とし、Valkeyを新規で空の状態で作成し、そのValkeyに対して同期を行う形としました。
データ移行について(RIOT実践編)
ここからは、RIOTを使ったリアルタイムデータ同期についてです。
1. 実行環境と「メモリ上限」の落とし穴
RIOTはJava実装のため、実行用のEC2にJava(Amazon Corretto等)をインストールして実行します。
※(参考)検証で使用したバージョン
RIOTはv4.3.0、Javaは17を使用しました。
ここで最初にハマったのがメモリ不足(OOM)です。
RIOT(JVM)はデフォルトでは実行インスタンスのメモリの約1/4しか使わない設定になっており、数百万件規模のキーを同期しようとするとすぐに落ちてしまいました。
これを防ぐため、実行前に環境変数でJVMのメモリ上限を引き上げます。
今回はメモリ32GBのインスタンスで20GBを割り当てました。
同期ワーカーを動かすのはグループD全体の対応が完了するまで数時間動かし続けるため、できるだけ安定した稼働ができるようにEC2インスタンスタイプはm7i.2xlargeとスペック高めのものを利用しました。
export JAVA_OPTS="-Xmx20g"
また、RIOTのLive同期を機能させるには、事前に同期元Redisのパラメータグループでnotify-keyspace-eventsを有効化(KEA等を設定)しておく必要があります。
なお、この通知を有効にすると通知発行の分、同期元Redisに多少の負荷がかかるようになります。
※ 事前に本番のRedisのCPU使用率を確認し、問題ないと判断してから臨みました。
実際はCPU数%の上昇でした。
2. ScanモードとLiveモード
RIOTのreplicateコマンドには主に2つのモードがあります。
- Scanモード (
--mode scan): 実行時点の既存データを全量スナップショットとして同期する - Liveモード (
--mode live): Scanの全量同期に加えて、Keyspace Notificationsを購読し、リアルタイムに発生した変更(SET/DELETE等)も継続して同期し続ける
今回は同期中もサービスへの書き込みが継続するため、差分を継続同期するLiveモードを採用しました。
3. スレッド数とバッチサイズのチューニング
ただLiveモードを実行するだけでは、本番相当のトラフィックには追いつけず、同期漏れやRIOTのフリーズが発生しました。
ステージング環境で本番同等のデータとトラフィックを再現し、最適なオプションを探る検証を繰り返しました。
- スレッド数 (
--threads): デフォルトは1。
増やすと同期速度は上がるが、スレッド10前後まで上げると、RIOTプロセスが98%付近で停止して応答しなくなる事象が発生。
原因はネットワーク帯域が詰まっていたため、スレッド数は上げすぎない方向で調整した。 - バッチサイズ (
--batch): デフォルトは50。
バッチサイズを減らすと、リアルタイムで入ってくるデータの同期で不整合が起こることを確認。
バッチサイズを増やすと、ネットワーク帯域に負荷がかかるため、スレッド数同様上げすぎないよう方向で調整。
検証の過程では、スレッド数を上げてもキー差分(Missing)が必ずしも減るわけではないこと、そして同期速度のボトルネックはネットワーク帯域であることが分かってきました。
複数の値(スレッド5〜10など)を試し、フリーズを避けつつ欠損率0%で同期できる組み合わせを探りました。
最終的には、スレッド/バッチともにデフォルト(1/50)で実行するという設定値に落ち着きました。
本ケースにおいては、本番相当の負荷ではデフォルトが最適だったということになります。
同期コマンドの例
riot replicate \
  --struct \
  --threads 1 \
  --batch 50 \
  --mode live \
  --source-cluster \
  --target-cluster \
  --log-file=riot_sync.log \
  {同期元Redisエンドポイント} \
  {同期先Valkeyエンドポイント}
4. 移行の確実性を担保する2段階の検証
データが本当に欠損なく同期されているかを担保するため、切り替え直前に2つの方法で検証しました。
- RIOTのcompare機能:
compareコマンドで切り替え前時点での差分がないかの確認を行いました。
TTL(有効期限)は同期タイミングで数秒のズレが生じるため、--ttl-toleranceを大きめに設定して純粋なKeyとValueの差分だけを抽出しました。 - 独自の欠損率確認スクリプト: テスト用データを1秒間隔で連続して書き込み、同期先Valkeyに存在するか(Missingがないか)をチェックするPythonスクリプトを自作し、同期が成功しているかの確認を行いました。
また、リソース競合を避けるため、RIOT実行サーバーとは別のEC2で実行しました。
なお、compareを実行すると、数件のMISSINGやVALUE差分が検出されることがあります。
精査した結果、すべてTTL満了によるキー消失や同期タイミングのズレに起因するもので、--ttl-toleranceで除外した後の純粋なKey/Valueの実差分は0でした。
compareコマンドの例
riot compare \
  --source-cluster \
  --target-cluster \
  --ttl-tolerance 100000 \
  --show-diffs \
  --log-file=riot_compare.log \
  {同期元Redisエンドポイント} \
  {同期先Valkeyエンドポイント}
※ ttl-toleranceは許容するTTL差分の範囲の設定値。単位指定がなければミリ秒扱いになるため、コマンド例の場合100秒以内であれば差分なしと判断される。
こうしたチューニングと2段階の検証により、当日は最もクリティカルなセッションデータ等においても、実質的な欠損率0%での同期・切り替えを達成できました。
当日の切り替えの流れ
ここまで移行方法や同期ワーカーについて説明してきました。
これらを踏まえると、各グループごとの当日の切り替えの流れは以下のようになります。
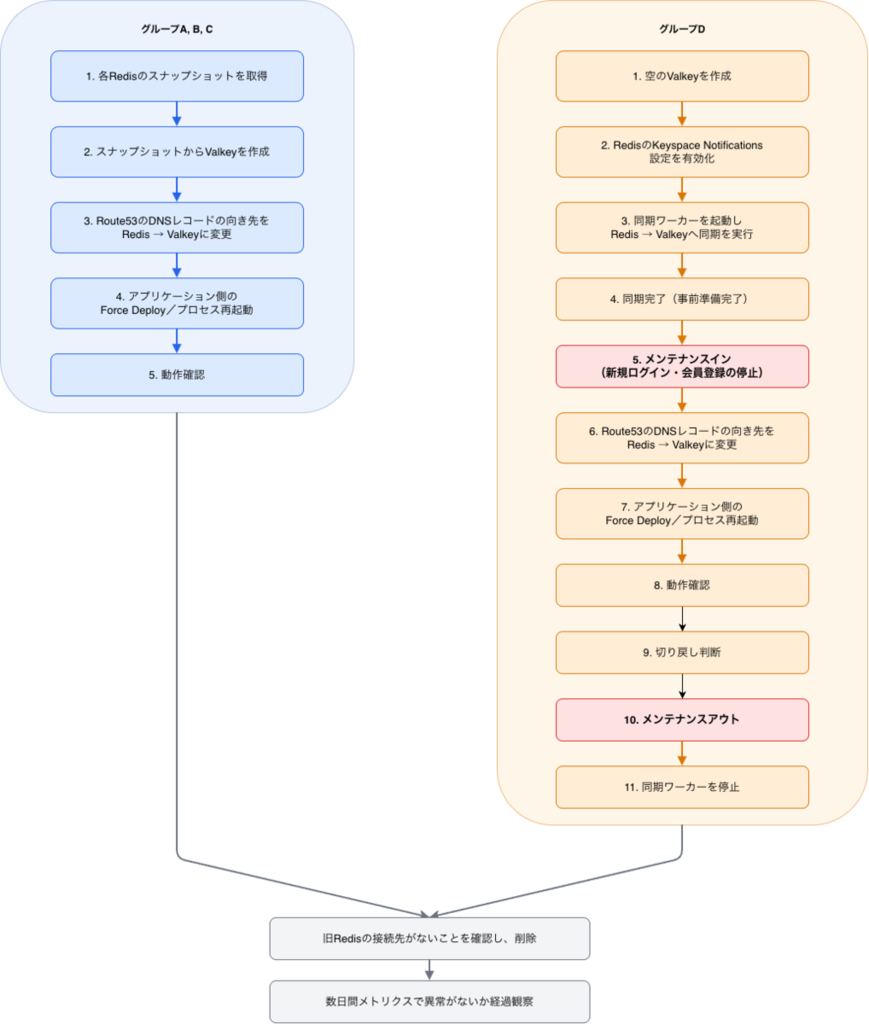
グループA・B・C
- 各Redisのスナップショットを取得
- スナップショットからValkeyを作成
- Route 53のDNSレコードの向き先をRedis -> Valkeyに変更
- アプリケーション側のForce Deployやプロセス再起動を実施
- 動作確認
- 旧Redisの接続先がないことを確認し、削除
- 数日間メトリクスで異常がないか経過観察
グループD
- Valkeyを新規に空の状態で作成
- RedisのKeyspace Notifications設定を有効にする
- 同期ワーカーを起動し、Redis -> Valkeyへの同期を実行
- 同期完了(事前準備完了)
- メンテナンスイン(新規ログイン・会員登録の停止)
- Route 53のDNSレコードの向き先をRedis -> Valkeyに変更
- アプリケーション側のForce Deployやプロセス再起動を実施
- 動作確認
- 切り戻し判断
- メンテナンスアウト
- 同期ワーカーを停止
- 旧Redisの接続先がないことを確認し、削除
- 数日間メトリクスで異常がないか経過観察
整理すると、
| A/B/C | D | |
|---|---|---|
| Valkeyの作り方 | スナップショットから作成 | 空の状態で作成 |
| データ投入経路 | スナップショットの内容がそのまま最終データ | RIOTのScan+Live同期がすべて |
| 前提 | 切り替え前後でのデータ欠損が許容される | 切り替え前後でのデータ欠損が許容されない |
移行時間
同期ワーカーで移行したグループDのRedisについては、一番大きいRedis(全Key数が数千万規模でメモリ容量が約165GB)で同期が完了するまで1時間ほどかかりました。
負荷(同期ワーカー実行中)
- CPU: 同期によるCPU負荷上昇はほとんど起きませんでした。
- レイテンシー: 若干の上昇はあったものの、サービスに影響があるレベルではありませんでした。
- ネットワーク帯域: 移行開始時に多少上がったものの、サービス影響が出るレベルではありませんでした。
同期レイテンシ
同期元Redisへの書き込みが同期先Valkeyに反映されるまでの遅延は、計測値としては記録していませんが、欠損率確認スクリプトや目視での確認ベースでは、おおむね1秒以内(1秒あるかないか程度)でした。
動作確認と事後処理
切り替え作業(DNSエンドポイントの変更)後は、以下を行いました。
- アプリケーションの強制デプロイ・再起動: 後述のトラブルの通り、DNSを切り替えただけでは新しいValkeyを認識しないため、ECSのForce DeployやEC2プロセスの再起動を実施。
- 動作確認: 切り替え後すぐにPostmanのコレクションRunでValkeyに対して、書き込み・更新・参照・削除をそれぞれ行うAPIを一連で実行し、最低限の確認を実施。
その後リグレッションテストを行い、クリティカルな動作のピンポイント確認を優先して確認を進めた。
ここで問題がなければメンテナンスアウトし、同期ワーカー停止後に旧Redisへの接続が残っていないか確認し、Redisの削除を実施した。 - 事後処理: 数日間、各種メトリクス(CPU、メモリ、レイテンシー等)を監視し、傾向に異常がないことを確認。
旧Redis削除時は、
redis-cliのclient listで接続中のクライアントが残っていないか(デプロイサーバー以外が繋いでいないか)を確認してから実施してください。
切り戻し(ロールバック)方針とその弱点
新Valkeyへの切り替え後もしばらく旧Redisを削除せず維持し、問題発生時はDNSの再変更 + アプリ再起動のみですぐに旧環境へ切り戻せる状態を担保しました。
ただし、正直に書いておくと弱点もあります。
切り替え後の「新Valkey → 旧Redis」への逆同期は用意していないため、万が一切り戻すと、切り替え後に新Valkeyへ書き込まれた分のデータが旧Redis側の内容まで先祖返りします(例: 切り戻し直前に更新されたセッション情報が、切り替え時点の古い状態に戻る)。
このデータの先祖返りについては、「起きても実害がないか」を事前に検証しています。
具体的には、切り替え直後を想定してデータをあえて古い状態に戻した状態でアプリケーションにアクセスし、フロントで異常なエラーが出ないか、致命的な不整合が起きないかを確認しました。
結果として、ログインセッション系のRedisは先祖返りが不整合に直結するため、先祖返りが許容できないことがわかりました。
そのため、ログインセッション系で新規セッションが発生しない状態(メンテナンス)を作り、メンテナンス中に切り替えと動作確認を行い、切り戻し判断はメンテナンス明け前に行う運用としました。
これにより、仮に切り戻してもメンテナンス中に新規発生したセッションが存在せず、不整合が生じない状態にすることができます。
ログインセッション系以外のRedisについては、想定される先祖返りの範囲では大きな問題は発生しないことを確認できたため、「逆同期なしの切り戻し」を許容する方針としました。
移行時に直面したトラブルと回避策
本番実施時には特段のトラブルはありませんでしたが、事前の開発環境でのリハーサルでDNS切り替え後のIPアドレスキャッシュ問題に直面しました。
内容としては、Route 53で向き先を新Valkeyへ変更しても、アプリケーションが名前解決結果(旧RedisのIPアドレス)をキャッシュし続け、旧環境へ接続し続けるというものです。
対処として、DNS切り替え直後にECSのForce DeployやEC2の再起動をセットで行い、強制的に新しいIPを再取得させる運用としました。
これを踏まえ、Force Deployや再起動を自動実行できるスクリプトを用意したことで、本番では切り替えまでをスムーズに行えました。
また、DNSキャッシュ対策としては他にもRoute 53のTTLを事前に下げておくなどが有効かと思いますが、今回はForce Deployや再起動で強制的にキャッシュをリフレッシュする方法を取りました。
※補足: 接続経路によって挙動が異なる場合があります。
アプリケーションが直接Redisに接続しているケースと、twemproxyなどのプロキシを経由しているケースでは、IPを再取得させるために再起動すべき対象が変わります。
あらかじめ環境の接続構成を洗い出し、それぞれどの対応が必要か確認しておくことが重要です。
まとめ
Amazon ElastiCache for Redis v5からValkey v8への移行を、以下の方針で実質欠損率0%で完了できました。
- データの欠損許容度でRedisをグループ分けし、そのグループごとでValkeyへの移行を実施。
- ブルー/グリーン方式(スナップショットから新規Valkeyを作成しRoute 53で切替)を採用し、DB切り替えのダウンタイムをゼロに。問題時はDNSを戻すだけで即ロールバックできる安全性も確保。
- 欠損が許容されないRedisは、RIOTのLive同期でリアルタイムに差分を追従。
- 切り戻し時の先祖返り対策として、ログインセッション系は新規セッションが発生しないメンテ枠内で切り替え〜切り戻し判断まで完結させた。
- 事前に起きえる問題とその影響を整理し、許容できる部分とそうでない部分を把握しておく。
インプレースアップグレードに比べると工数は確実に増えますが、「クリティカルなデータをダウンタイムなし・ロールバック可能な形で移行したい」という要件には、今回の方式がよく噛み合ったと感じています。
同様の移行を検討している方の参考になれば幸いです。
最後まで読んでいただきありがとうございました!
参考リンク
- Redisライセンス(公式): https://redis.io/legal/licenses/
- RIOT: https://github.com/redis/riot
- RedisShake: https://github.com/tair-opensource/RedisShake
- AWS事例: Amazon Adsの ElastiCache for Valkey移行: https://aws.amazon.com/jp/blogs/database/amazon-ads-upgrades-to-amazon-elasticache-for-valkey-to-achieve-12-higher-throughput-and-save-over-45-in-infrastructure-costs/
- Amazon ElastiCache 料金: https://aws.amazon.com/jp/elasticache/pricing/
